

글로벌 기업을 위한 고품질 AI 번역 품질
언어 전문가와 분석가, 그리고 전 세계 20만 개 이상의 기업은 DeepL을 텍스트, 음성, 문서 전반에서 가장 정확한 AI 번역 솔루션으로 평가합니다.
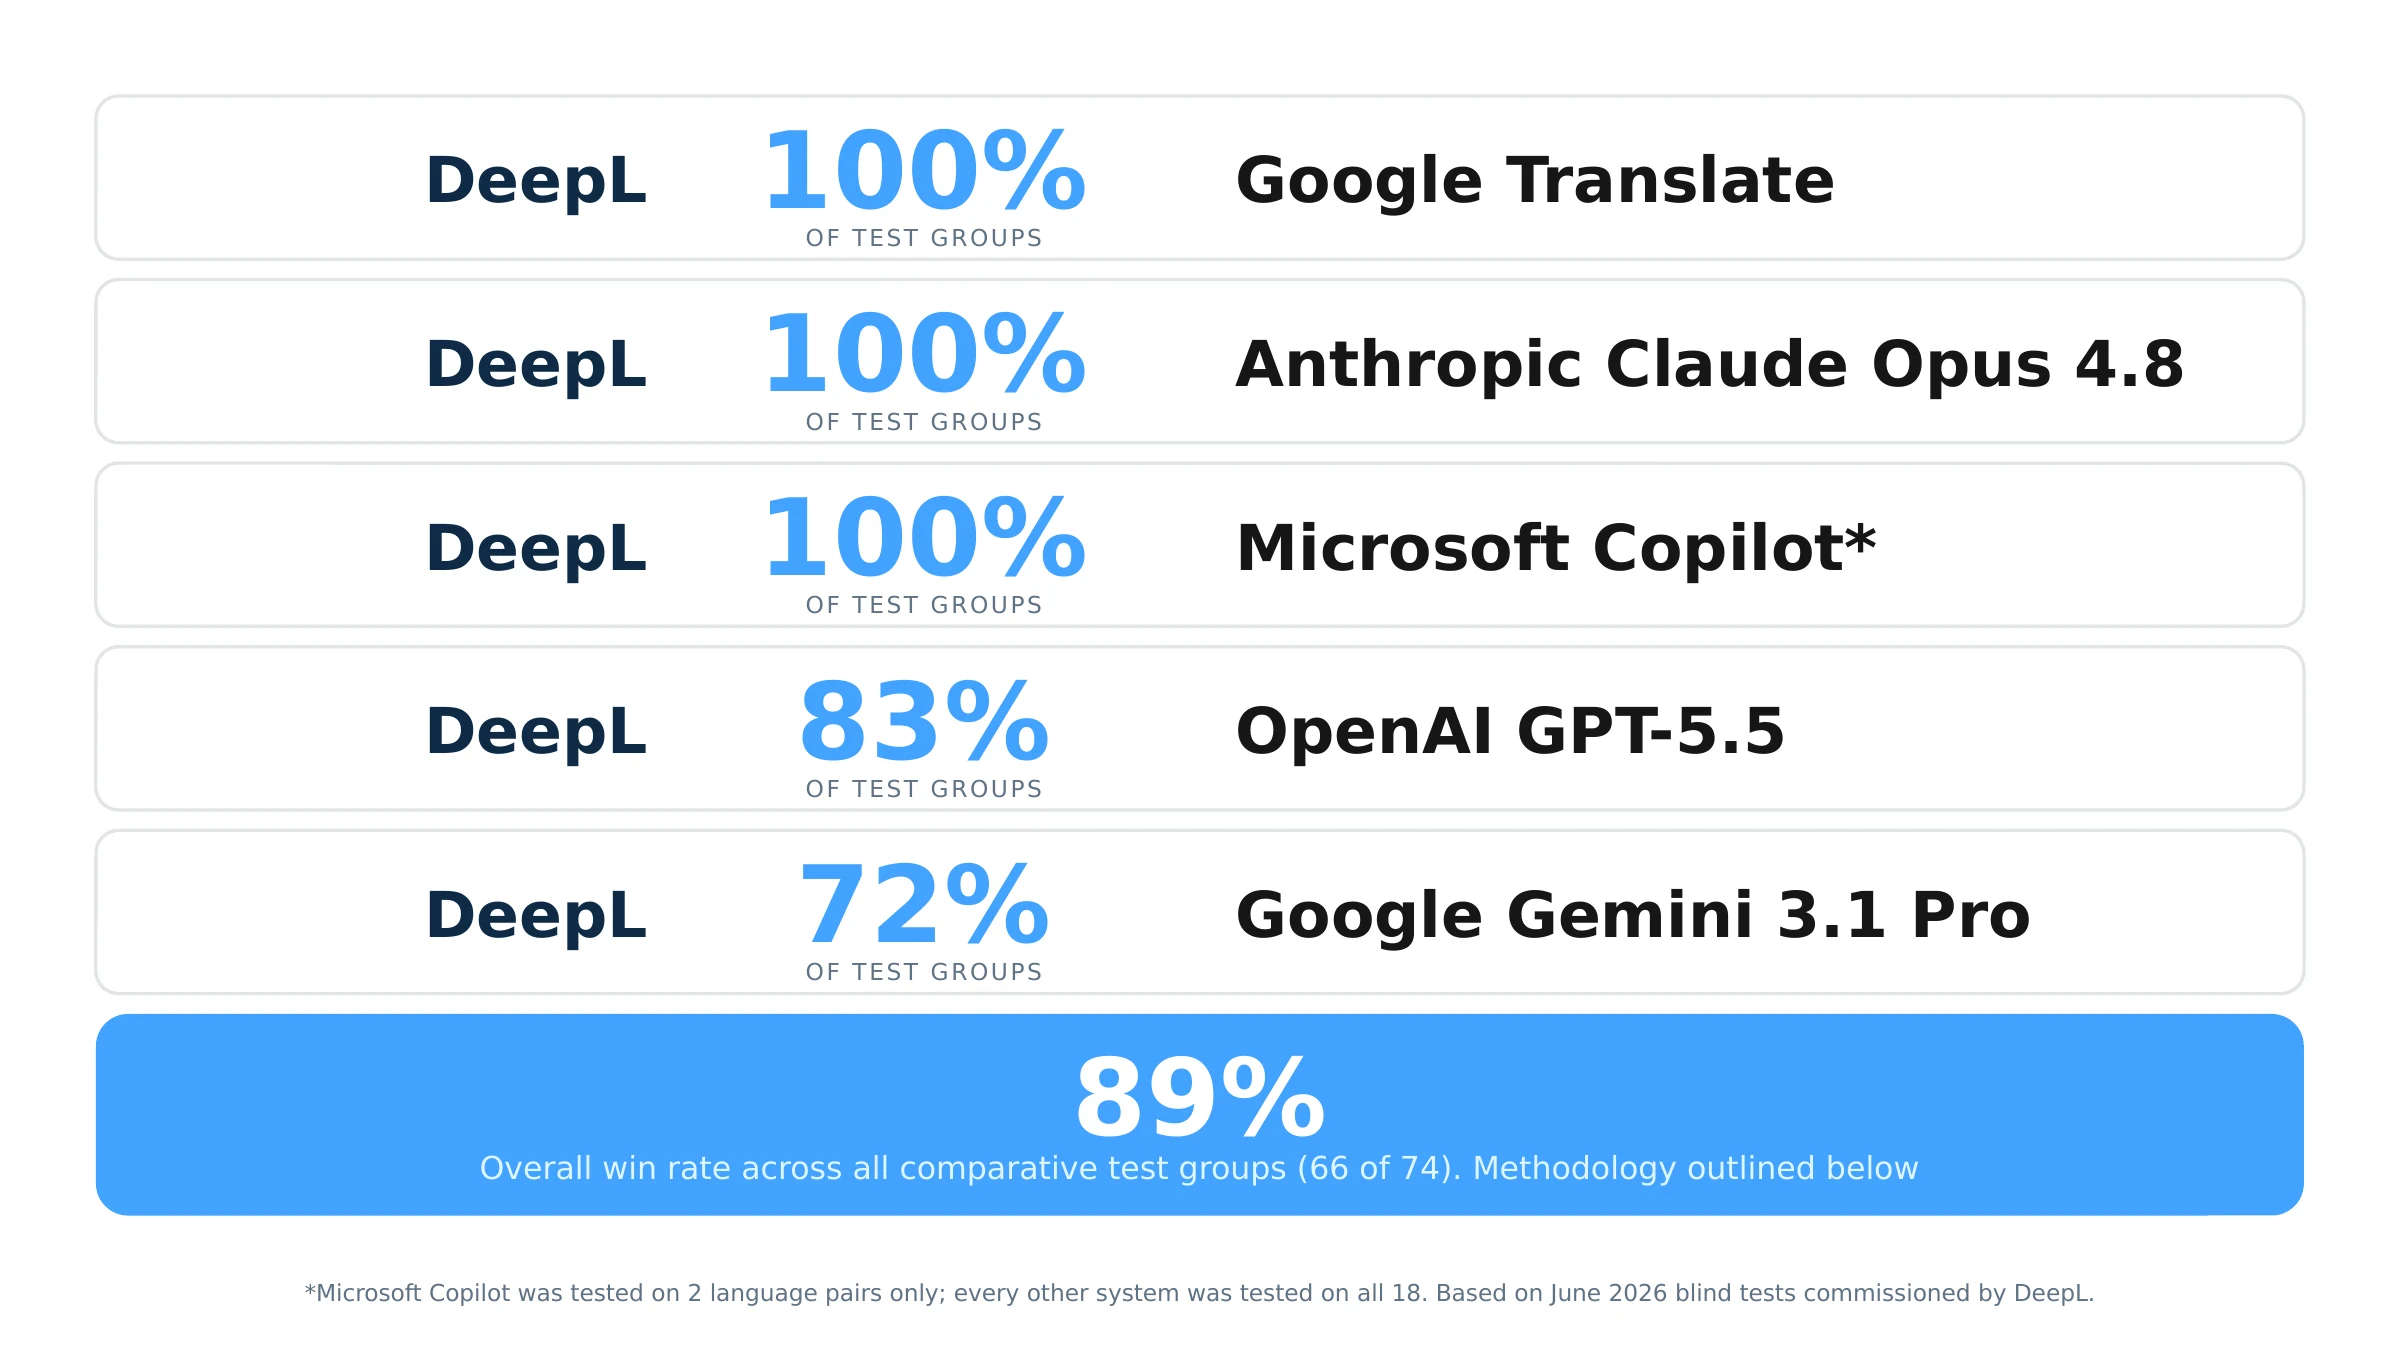
DeepL은 테스트 그룹 대비 89%의 승률을 기록
텍스트 번역 품질품질 점수 96.4
음성 번역 품질 - Microsoft Teams, Google Meet, Zoom 평균 87~89점을 상회하는 DeepL 평가 점수(2026년 Slator 보고서)100개 이상의 언어
문서 번역 품질 - 100개 이상의 언어로 모든 주요 형식 파일을 레이아웃 손상 없이 번역신뢰할 수 있는 번역 품질
DeepL은 18개 언어 쌍과 7개 경쟁 모델을 대상으로 한 직접 비교 평가에서 89%(74개 중 66개)의 승률을 기록했습니다.*
업계 최고 수준의 음성 번역
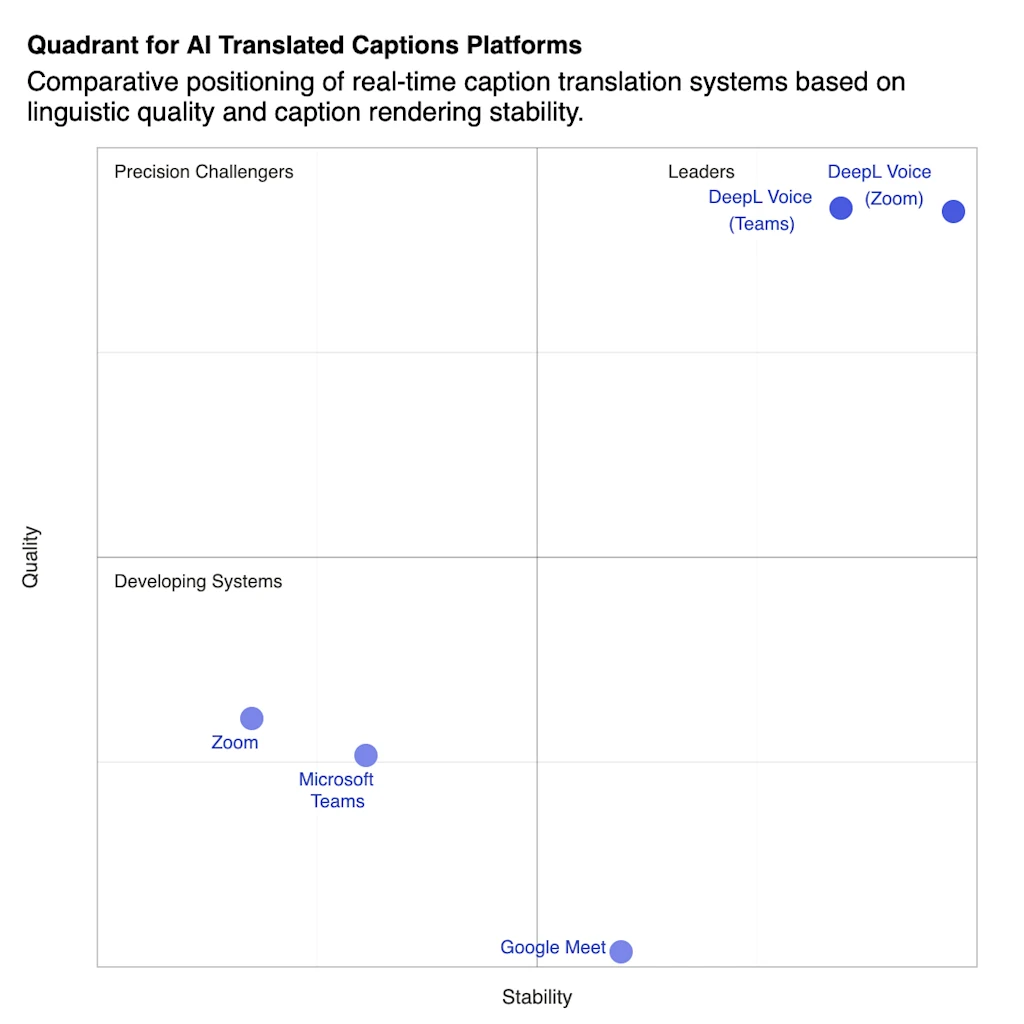
2026년 3월 Slator의 AI 번역 자막 시장 분석에서 언어 전문가의 96%가 DeepL Voice를 1위로 평가했습니다.
- 평가 대상 플랫폼 대비 중대하거나 심각한 번역 오류가 76% 적음
- 세그먼트당 오류 발생률이 Microsoft Teams 대비 66%, Zoom 대비 64% 적음
- Zoom에서 품질 점수 96.4점, Teams에서 96.3점 기록, 기타 플랫폼은 87~89점 수준
자막 안정성 평가에서 88.6점과 85.8점을 기록하며 경쟁 솔루션 대비 우수한 성능 입증
브랜드를 위해 설계된 유일한 AI 번역 솔루션
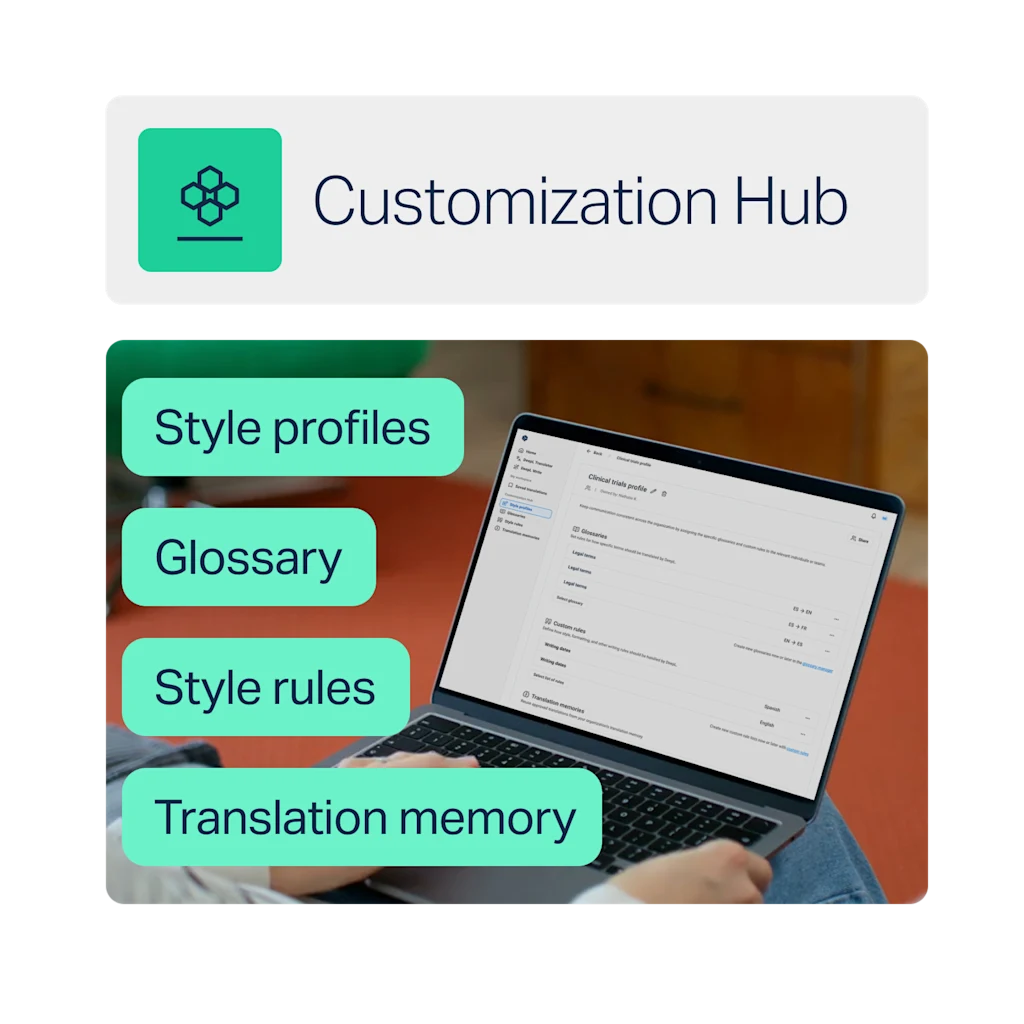
번역 품질은 단순한 언어 변환에 그치지 않습니다. 전문 용어, 어조, 그리고 독창적인 스타일까지 일관되게 반영해야 합니다. DeepL Customization Hub는 팀이 용어집, 스타일 규칙, 번역 메모리 및 스타일 프로필을 통해 브랜드 메시지, 용어 및 스타일을 대규모로 관리하고 확장하도록 지원하는 기업용 제어 계층을 제공합니다.
DeepL은 범용 AI 모델 특유의 획일적인 번역이 아닌, 언제나 정확하고 일관되며 브랜드 메시지에 부합하는 번역을 제공합니다.
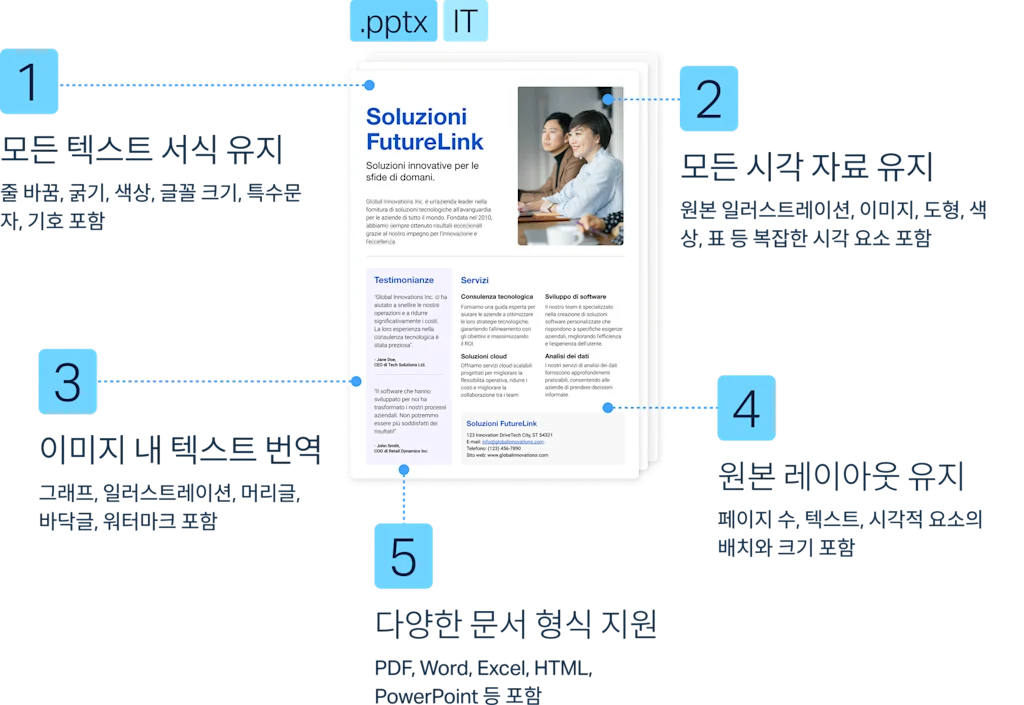
픽셀 단위의 정확한 대규모 문서 번역
DeepL 문서 번역은 원본 디자인의 서식 및 레이아웃과 시각적 맥락을 그대로 유지하면서 PDF 및 기타 30종 이상의 문서 형식을 100개 이상의 언어로 즉시 번역하여 시간, 노력, 비용을 절약할 수 있습니다.
최고의 AI 번역이 비즈니스 성과를 높이는 이유
DeepL의 번역 품질이 비즈니스 가치를 창출하는 10가지 방법
- 345% ROI - Forrester TEI 연구 기준 3년간 ROI
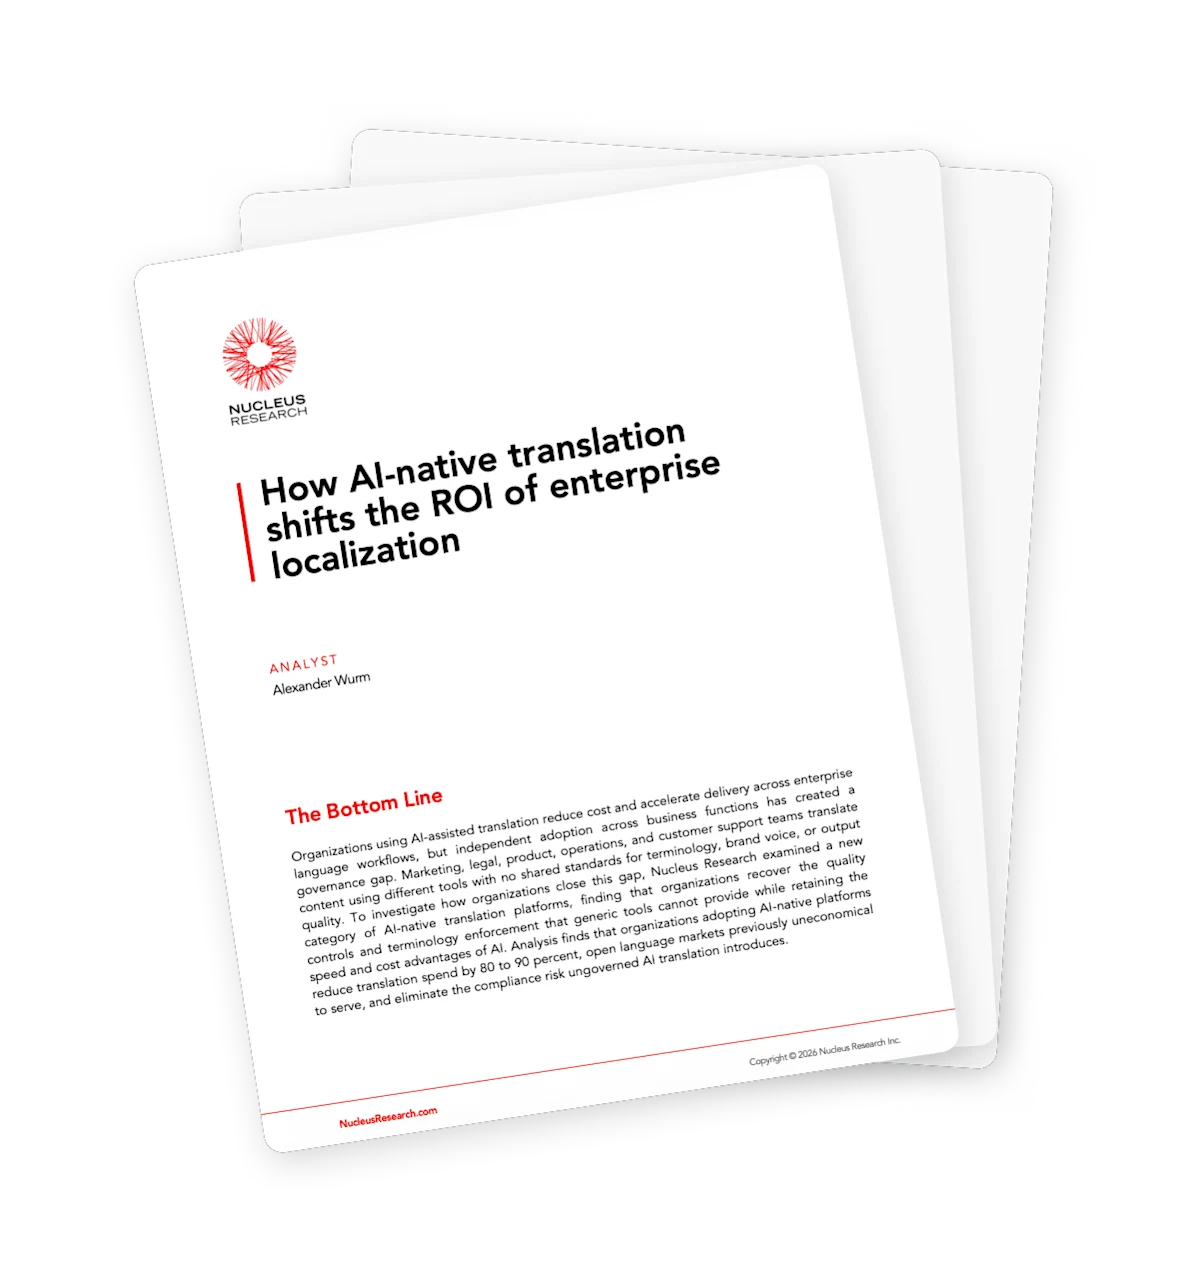
- 80~90% 비용 절감 - AI 기반 플랫폼 도입 기업 기준 번역 비용 80~90% 절감 - Nucleus Research
- LSP 및 외부 서비스 비용 감소 - 글로벌 콘텐츠 운영 전반의 지연을 줄이고 외부 서비스 비용 절감
- 더 빠른 시장 진출 - 병목 현상 없이 새로운 시장에 진출하고 고객의 언어로 서비스 제공
- 번역 주기 90% 단축 - 번역 소요 시간을 며칠에서 몇 시간으로 단축
- 위험 및 규정 준수 부담 해소 - SOC 2 Type II, ISO 27001, GDPR 준수로 고객 콘텐츠 학습 불필요
- 브랜드 일관성 강화 -모든 언어와 시장에서 용어, 어조 및 문체 유지
- 번역 업무량 50% 감소 - 언어 전문가와 콘텐츠 팀의 반복적인 사후 편집 업무 부담 해소
- 매출 성장 - 소비자의 76%는 정보가 모국어로 제공될 경우 해당 제품을 구매할 가능성이 더 높음
- 언어를 성장 동력으로 전환 - AI 기반 번역을 통해 현지화를 단순한 외주 비용에서 확장성 있는 수익 창출 역량으로 전환
번역 비용 절감 그 이상의 가치
비즈니스가 성장할수록 번역 에이전시 비용도 함께 증가합니다. 범용 AI는 중요한 콘텐츠를 맡기기에는 신뢰할 수 없습니다. 이 둘을 모두 관리하는 데에도 상당한 시간이 필요합니다.
독립 글로벌 기술 리서치 기업 Nucleus Research는 이러한 영향을 정량적으로 분석하여 DeepL 모델의 우수성을 확인했습니다.
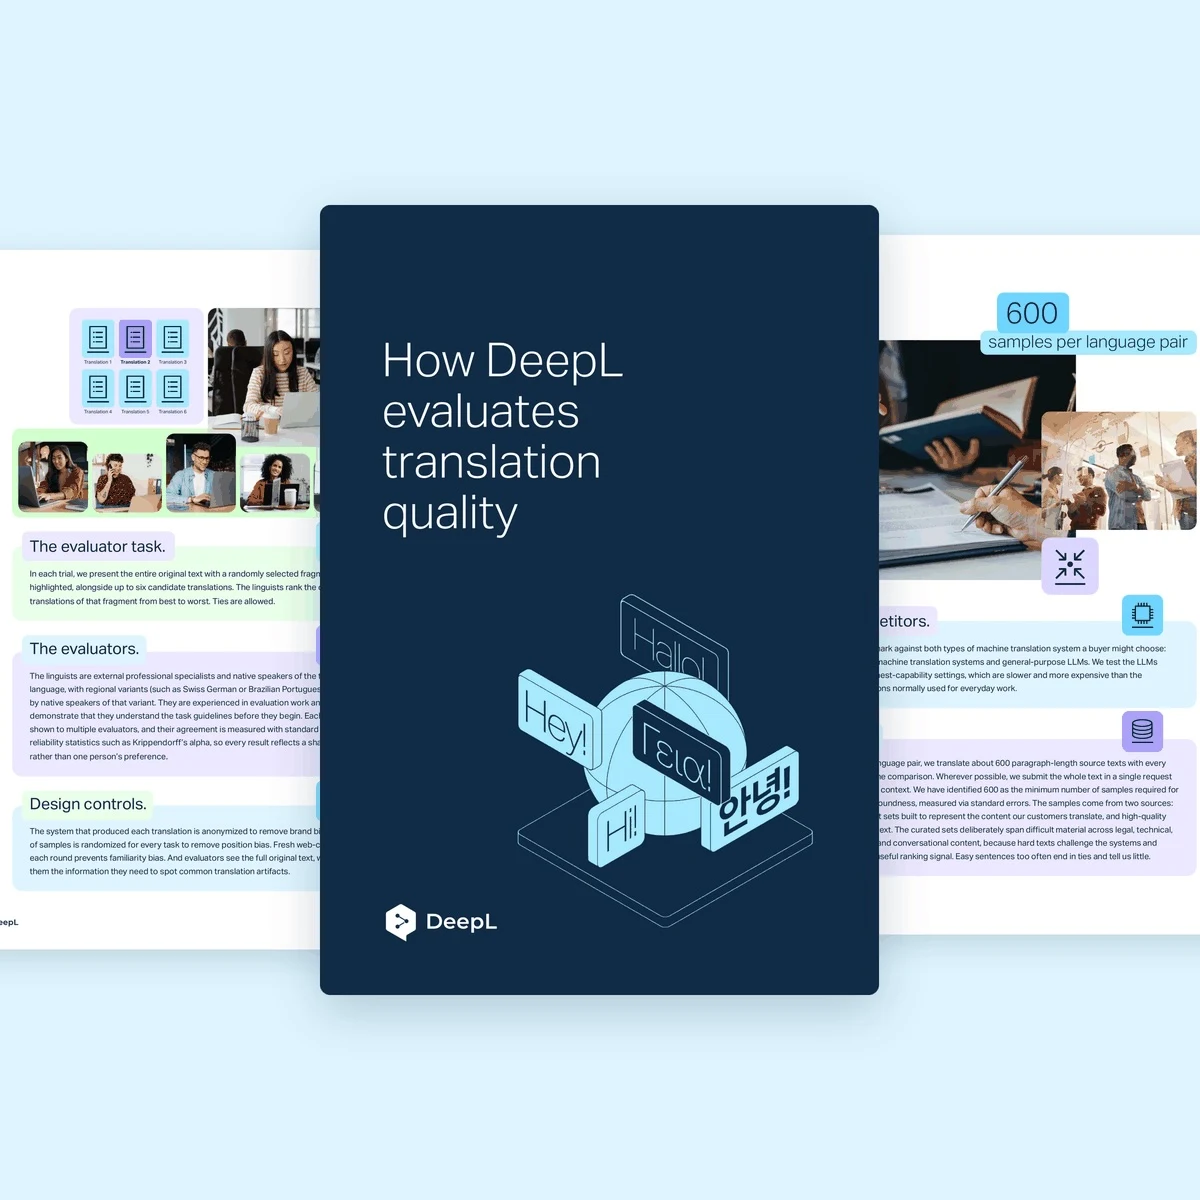
DeepL 번역 품질의 과학적 근거
텍스트 번역 품질은 측정하기 어렵고 결과를 인위적으로 조정하기도 쉽습니다. 이 백서에서는 DeepL이 블라인드 방식의 인간 평가를 통해 품질을 평가하는 방법, BLEU와 COMET 같은 기존 평가 지표의 한계, 그리고 DeepL의 벤치마킹 방법론이 실제로 무엇을 평가하는지 설명합니다.
20만 개 이상의 기업이 번역 품질에서 DeepL을 신뢰하는 이유
고객의 생생한 후기
“DeepL Voice for Meetings가 전 세계 직원들을 정서적으로 더욱 가깝게 만들었다는 점은 의심의 여지가 없습니다.”
“DeepL은 일상적인 번역 업무에 커다란 영향을 미쳤으며, 이는 고객의 비용 절감으로 이어질 뿐만 아니라 프로젝트 진행 효율을 높여주었습니다.”
“DeepL의 기계번역 품질은 여전히 시장 최고 수준입니다.”
“예전에는 업무가 비효율적으로 진행되었습니다. 60분짜리 회의는 종종 30분씩 더 길어지곤 했습니다. DeepL Voice를 도입한 이후, 모든 참여자가 적극적으로 대화에 참여할 수 있습니다.”
“지연, 도입 편의성, 비용, 이 모든 요소가 중요하지만, 품질이야말로 가장 핵심입니다.”
“우리는 도구의 정확도 또한 평가합니다. 품질적인 측면이긴 하지만, 사내에서는 DeepL은 정확도가 매우 높고 사용하기 쉽다는 평가를 받습니다.”
최고의 AI 번역 솔루션 알아보기
DeepL은 독립 블라인드 테스트에서 언어 전문가들이 가장 높게 평가한 AI 번역 솔루션입니다. 2026년 6월 실시된 블라인드 테스트에서 DeepL은 OpenAI GPT-5.5, Gemini 3.1 Pro, Claude Opus 4.8, Google 번역, Microsoft Copilot 대비 89%의 승률을 기록했습니다.
네, 그렇습니다. 블라인드 테스트에서 DeepL은 고급 추론 기능이 활성화된 OpenAI GPT-5.5를 상대로 한 비교 테스트 그룹에서 83%(18개 언어 쌍 중 15개)의 승률을 기록했습니다.
2026년 6월 실시된 블라인드 테스트에서 DeepL은 Google 번역을 상대로 한 비교 테스트 그룹에서 100%(18개 언어 쌍 중 18개) 승률을 기록했습니다.
음성 번역의 경우 30개 이상, 텍스트와 문서 번역의 경우 100개 이상의 언어를 지원합니다.
네, 그렇습니다. DeepL은 SOC 2 Type II 인증, ISO 27001 인증을 획득했으며 GDPR을 준수합니다. DeepL은 고객 데이터를 보관하지 않으며, 고객 콘텐츠를 학습에 사용하지 않습니다.